
ビッグデータの収集から活用まで、分析段階の作業を見分ける
情報セキュリティマネジメント試験 令和8年度 問11 / システム戦略 › システム活用促進・評価
過去問にチャレンジ
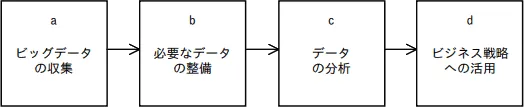
eコマース運営会社がビッグデータを用いて新たなニーズを発掘し,その後のビジネス戦略に生かそうとしている。ビッグデータの収集から活用までのフローを次の図のようにしたとき,データの分析で行うことはどれか。ここで,選択肢ア~エは,フロー図のa~dのいずれかに対応している。
- ア
機械学習を用いて自然言語処理やクラスタリングを行い,新しい傾向を導き出す。
- イ
取扱い製品に関するSNSでの評価などを自動プログラムで取得する。
- ウ
ノイズリダクション処理やデータクレンジング処理を行う。
- エ
発見した新しい傾向を見極めて,注力すべきビジネス戦略を立案する。
会話形式の解説
 講師
今回は、ビッグデータを集めてからビジネスに生かすまでの流れの問題です。図では、ビッグデータの収集、必要なデータの整備、データの分析、ビジネス戦略への活用の4段階が順に並んでいます。各選択肢がどの段階の作業なのかを振り分けるのがポイントです。
 受験者
4つの選択肢が4つの段階に1つずつ対応しているのですね。私はノイズリダクションやデータクレンジングも、データを処理しているので分析のように思えてしまいました。
講師そこは取り違えやすいところです。データクレンジングは、欠けている値や重複、表記の揺れ、ノイズを取り除いたり直したりして、データを分析に使える状態に整える作業です。分析の前に行う下準備なので、図の「必要なデータの整備」に当たります。
受験者整えるだけでは、まだ新しいことは何も分かっていないということですか。
講師そのとおりです。見分けるときは、その作業で新しい知見が生まれるかどうかに注目します。機械学習で自然言語処理やクラスタリングを行い、新しい傾向を導き出す選択肢は、まさに傾向を見つけているので「データの分析」に当たります。これが正解です。
受験者自然言語処理とクラスタリングは、それぞれ何をするものですか。
講師自然言語処理を使うと、口コミなどの文章から評価や話題を取り出せます。クラスタリングは、特徴の似た顧客や商品をグループに分ける手法です。どちらも、整えたデータから規則性や傾向を見つけるための作業です。
受験者SNSでの製品の評価を自動プログラムで取得する選択肢は、材料を手に入れているだけなので「ビッグデータの収集」ですね。
講師はい。データを集めているだけで、まだ傾向は見つけていません。では、発見した新しい傾向を見極めてビジネス戦略を立案する選択肢はどうでしょう。
受験者「発見した新しい傾向」とあるので、分析はもう済んでいます。その結果を戦略に結び付けているので「ビジネス戦略への活用」だと思います。
講師正確です。まとめると、データを集めるのが収集、使える形に整えるのが整備、傾向が見つかれば分析、戦略を決めていれば活用です。なお、分析は機械学習に限らず、単純な集計や可視化も含みます。「処理」という言葉に引きずられず、作業の結果に何が得られるかで判断するとよいです。
まとめ
ビッグデータを活用する流れは、収集、整備(前処理)、分析、活用の順で整理できます。SNSの評価を自動取得するのは収集、ノイズリダクションやデータクレンジングは整備、機械学習による自然言語処理やクラスタリングで新しい傾向を導き出すのが分析、見つけた傾向から戦略を立てるのが活用です。データクレンジングは「処理」という言葉から分析と取り違えやすいですが、新しい知見を生まない下準備なので整備に当たります。作業の結果として新しい知見が得られるかどうかに注目すると、段階を見分けやすくなります。
解答・解説
正解はアです
この問題のテーマ
ビッグデータを集めてビジネスに生かすまでの流れ(収集→整備→分析→活用)のうち、「データの分析」の段階で行う作業を選ぶ問題です。
解き方の考え方
図では、a「ビッグデータの収集」、b「必要なデータの整備」、c「データの分析」、d「ビジネス戦略への活用」の順に並んでいます。どの選択肢も4段階のいずれか1つに当たるので、それぞれの作業がどの段階のものかを振り分けます。データを集める作業はa、使える形に整える作業はb、傾向を見つける作業はc、結果を戦略に結び付ける作業はdです。こうして選択肢を当てはめると、cに残るものが正解です。
選択肢ごとの解説
- ○ア 機械学習を用いて自然言語処理やクラスタリングを行い,新しい傾向を導き出す。機械学習で自然言語処理やクラスタリングを行い、新しい傾向を導き出すという説明は、図のc「データの分析」に当たります。自然言語処理を使うと、口コミなどの文章から評価や話題を取り出せます。クラスタリングは、特徴の似た顧客や商品をグループに分ける手法です。どちらも、整えたデータから規則性や傾向を見つけるための作業です。
- ×イ 取扱い製品に関するSNSでの評価などを自動プログラムで取得する。SNSでの製品の評価などを自動プログラムで取得する作業は、分析の材料を集める段階なので、図のa「ビッグデータの収集」に当たります。データを手に入れているだけで、まだ傾向を見つけてはいません。
- ×ウ ノイズリダクション処理やデータクレンジング処理を行う。ノイズリダクションやデータクレンジングは、分析の前に行う下準備で、図のb「必要なデータの整備」に当たります。クレンジングでは、欠けている値、重複、表記の揺れ、ノイズを取り除いたり直したりして、データを分析に使える状態に整えます。
- ×エ 発見した新しい傾向を見極めて,注力すべきビジネス戦略を立案する。見つけた傾向をもとに力を入れるべきビジネス戦略を立てる作業は、分析が終わった後に行うもので、図のd「ビジネス戦略への活用」に当たります。「発見した新しい傾向」とあるので、分析はすでに済んでいることが読み取れます。
補足
データを「処理する」という言葉に引きずられて、クレンジングを分析と取り違えるのがよくある引っかけです。見分けるときは、その作業で新しい知見が生まれるかどうかに注目します。データを整えるだけなら整備、傾向が見つかれば分析、戦略を決めていれば活用と考えると判断しやすくなります。なお、分析は機械学習に限らず、単純な集計や可視化も含みます。
POINT
- ビッグデータを活用する流れは、収集、整備(前処理)、分析、活用の順で整理できます。
- データクレンジングやノイズの除去は、分析そのものではなく、その前に行う整備の作業です。
- 分析は、整えたデータから規則性や新しい傾向を見つける段階で、自然言語処理やクラスタリングはその代表的な手法です。
- 分析の結果を意思決定や施策の立案に結び付けるのが活用の段階です。